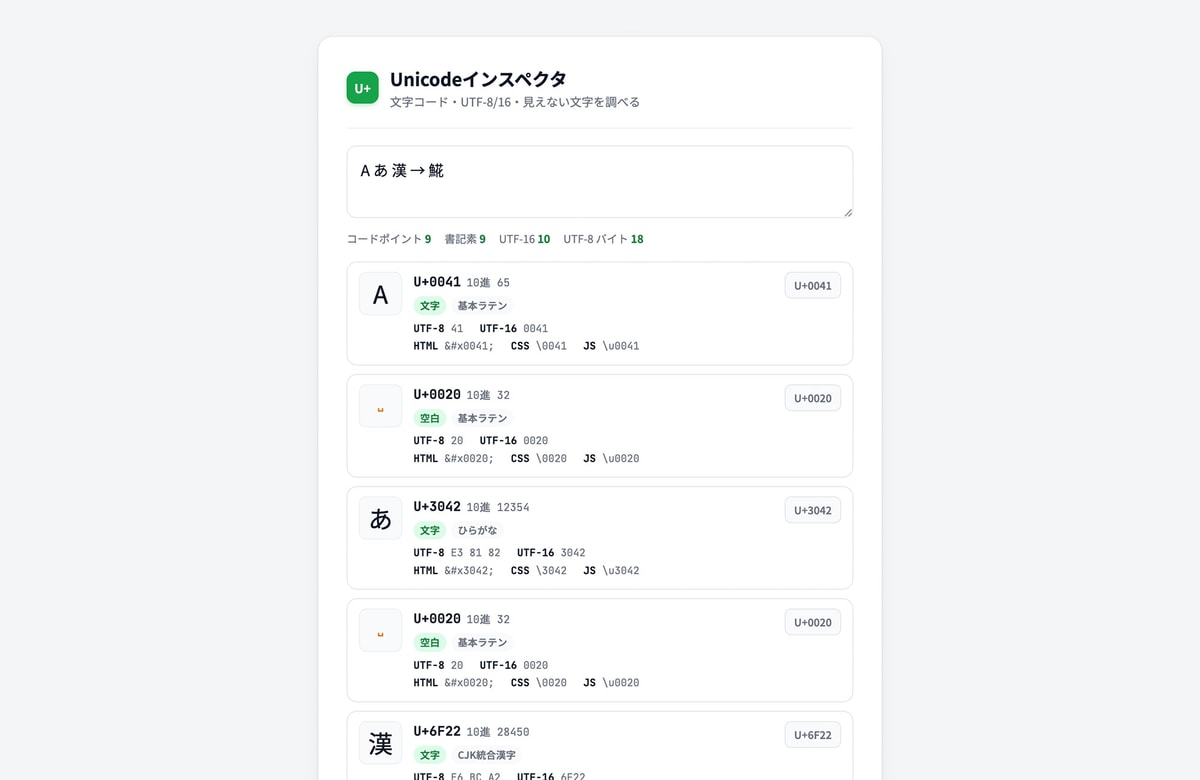
検索しても引っかからない、CSVを読み込むと列がずれる、書いたはずのCSSが効かない。原因を追いかけても、コードには何も間違いが見つからない。そんなときの犯人が、テキストに紛れ込んだ目に見えない文字だったというのは珍しくありません。デザイン事務所AMIXは、貼り付けた文字を1文字ずつ分解し、コードポイントからバイト列、エスケープ表記までまとめて表示する無料Webツール「Unicodeインスペクタ」を公開しました。ゼロ幅文字や異体字セレクタ、全角スペースといった「見た目では分からない文字」も可視化します。アプリのインストールやアカウント登録は不要で、ブラウザを開けばすぐに使い始められます。
どんなツールか
「Unicodeインスペクタ」は、入力欄に貼り付けたテキストを1コードポイントずつに切り分け、それぞれをカードとして縦に並べて見せるWebツールです。各カードには、その文字の見た目、コードポイント(U+ に続く16進数)と10進数の値、分類とUnicodeブロック、UTF-8のバイト列とUTF-16のコード単位、HTML/CSS/JavaScriptのエスケープ表記が入ります。ボタンを押す必要はなく、文字を打ったり貼ったりした瞬間に一覧が更新されます。
同じことを調べようとすると、文字コード表を検索し、変換サイトでUTF-8のバイト列を出し、エスケープ表記は別の資料を当たる、というように複数のページを行き来することになります。まして「どこかに変な文字が混ざっている」という状況では、そもそも調べる対象を特定できません。本ツールはテキストを丸ごと貼り付けて全文字を並べてしまうので、どの位置に何が入っているかを目で追って探せます。
処理はすべてお使いのブラウザ内で行われ、貼り付けたテキストが当方のサーバーへ送信・保存されることはありません。文字の解析は端末内で行いますが、機密情報や未公開の原稿・コードを扱う場合は、所属先の情報管理ルールに従ってください。パソコンでもスマートフォンでも同じように動き、初期状態では「A あ 漢 → 𩸽」というサンプルが入っているので、まず何が表示されるツールなのかをその場で確かめられます。
1文字ずつ分解して見える情報
入力欄の下には、まず全体のサマリーとして4つの数値が並びます。「コードポイント」は文字をコードポイント単位で数えた個数、「書記素」は見た目としてひとまとまりに見える単位の個数、「UTF-16」はJavaScriptなどが内部で扱う単位数、「UTF-8 バイト」はUTF-8で符号化したときの総バイト数です。たとえば「あ」だけでもUTF-8は3バイトとなり、4つの値は一致しません。コードポイント数とUTF-16の単位数の差、書記素数との差をそれぞれ見ると、サロゲートペアや結合文字についての手がかりになります。
続く一覧のカードには、まず左側に文字そのものが大きく表示されます。表示できない文字の場合はここが記号やラベルに切り替わり、半角スペースは「␣」、全角スペースは「□」、ノーブレークスペースは「NBSP」、タブは「⇥」、改行は「⏎」、復帰は「CR」、ゼロ幅系の文字は「ZW」、制御文字は「CTRL」、異体字セレクタは「VS」と表示されます。対象となる見えない文字をラベルで表示するため、空白に見える箇所の正体をその場で判別できます。
右側には情報がタグで並びます。ひとつ目は分類で、「文字」「数字」「記号」「約物」「空白」「制御」「結合文字」のいずれか(判定できない場合は「不明」)が付きます。ふたつ目はUnicodeブロック名で、「ひらがな」「カタカナ」「CJK統合漢字」「一般句読点」「半角・全角形」「顔文字」など90項目の範囲表をもとに日本語名で表示します。複数のUnicodeブロックをまとめた項目もあり、全ブロックを網羅しているわけではありません。3つ目以降には、必要に応じて「全角スペース」「ノーブレークスペース」「ゼロ幅スペース」「異体字セレクタ」「絵文字」「制御文字」「地域表示子」といった注意すべき性質のタグが加わります。絵文字以外のこうしたタグが付いた行は、カード全体が淡い色で強調されます。
“見えない文字”が起こすトラブル
見えない文字が混ざっていると、入力欄の上に「見えない文字が N 個含まれています」という警告が表示されます。対象になるのはゼロ幅系の文字、異体字セレクタ、そしてノーブレークスペースです。実務で厄介なのは、まさにこれらが「あるのに見えない」という点にあります。
ゼロ幅スペース(U+200B)は幅を持たない文字です。単語の途中にこれが1つ入っていると、人間の目には普通の単語に見えますが、検索やフィルタによっては別の文字列として扱われ、一致しないことがあります。「確かにこの語が書いてあるのに検索でヒットしない」の典型的な原因です。ノーブレークスペース(U+00A0)は見た目がほぼ半角スペースですが別の文字で、Webページからコピーしたテキストに紛れ込みやすく、数値の桁区切りに入り込むと表計算ソフトで数値として認識されない、といった事故になります。全角スペース(U+3000)も同様に、CSSのセレクタやクラス名、プログラムの識別子に混ざると、見た目は正しいのに動かないという状態を作ります。
BOM(U+FEFF)はファイルの先頭に付く印で、テキストとして読み込んだときに読み込むソフトによっては先頭の文字として残ることがあります。CSVの1列目の見出しが一致しない、出力の頭に余計な文字が出る、といった症状はこれが原因のことがあります。ゼロ幅接合子(U+200D、ZWJ)は絵文字をつなぐ役割の文字で、家族の絵文字などはZWJで複数の絵文字を連結して1つに見せています。コードポイント数などで制限する入力欄では、見た目の1文字を複数として数える場合があります。実際の数え方は入力先の仕様によります。本ツールはこうした文字を一覧の中に必ず1行として表示するので、どこに何個入っているかを位置ごと確認できます。
主な機能・特徴
文字を調べるために必要な情報が1画面にまとまっています。
- テキストを貼り付けた瞬間に解析が走り、1コードポイントずつカード表示されます。実行ボタンを押す必要はなく、文字を書き換えれば結果もその場で追随します。
- コードポイントは
U+の16進表記と10進数の両方を表示。仕様書は16進、プログラムのコードでは10進を使う、といった場面の行き来がしやすくなっています。 - 分類とUnicodeブロック名を日本語で表示。90項目の範囲表を備えているため、その文字がどの文字体系に属するのかを英語のブロック名を調べ直さずに把握できます。
- UTF-8のバイト列とUTF-16のコード単位を16進数で並記。同じ文字でも符号化方式によってバイト数が変わることを、実際の値で確認できます。
- HTML(
あ形式)・CSS(\3042形式)・JavaScript(\u3042形式、U+FFFFを超える文字は\u{1F600}形式)のエスケープ表記を自動生成します。 - 見えない文字はラベルに置き換えて表示し、該当行を強調。さらに入力欄の下に個数の警告が出るため、混入そのものに気づけます。
- 各カードの「U+…」ボタンでコードポイントをクリップボードへコピー。押すと表示が「済み」に変わります。ただしコピーに失敗しても表示が変わる実装のため、貼り付け結果も確認してください。
- 「コードポイント」「書記素」「UTF-16」「UTF-8 バイト」の4つの数え方を同時に表示。文字数制限のある入力欄で「何文字」と数えられるのかを検討する材料になります。
- 長いテキストを貼った場合は先頭300コードポイントまでを一覧表示し、「先頭 300 文字を表示しています(全 N 文字)」と全体の文字数を併記します。
使い方
手順は3ステップです。まず調べたい文字や文章を入力欄に貼り付けます。次に下に並ぶカードで、コードポイント・分類・ブロック・エスケープ表記を確認します。必要なコードポイントは、カード右側の「U+…」ボタンでコピーできます。
原因不明の不具合を追いかけているときは、疑わしい箇所を丸ごと貼り付けるのがおすすめです。1行のうちどこに問題があるか分からない状態でも、見えない文字が入っていれば警告が出て、該当のカードが強調表示されるので、探す手間がかかりません。逆に1文字だけを調べたいときは、その文字だけを貼れば一覧が1枚のカードになり、必要な情報だけが読めます。
サマリーの数値は、テキストの性質を素早くつかむのに役立ちます。「コードポイント」と「書記素」の数が違えば、結合文字や結合絵文字が含まれているということです。「UTF-16」の数がコードポイントより多ければ、U+10000 以降のサロゲートペア文字が混ざっています。初期表示のサンプルにある「𩸽」がその例です。
UTF-8とUTF-16で、同じ文字が違うバイト数になる
コードポイントは文字1つに割り当てられた番号にすぎず、それを実際のデータとして記録するには符号化方式を通す必要があります。UTF-8では、ASCIIの範囲の英数字が1バイト、ラテン文字の一部やギリシア文字などが2バイト、日本語のひらがな・カタカナ・漢字が3バイト、そして U+10000 以降の絵文字や拡張漢字が4バイトになります。一方のUTF-16は、基本的な文字を2バイト単位1つで表し、U+10000 以降だけをサロゲートペアという2単位の組み合わせで表します。
この違いは、実務では文字数制限の解釈として顔を出します。バイト数で上限が決まっているシステムでは、日本語1文字が3バイトを消費するのか2バイトなのかで入る量が変わります。プログラム側の文字列長がUTF-16単位で数えられていれば、絵文字1つが2としてカウントされます。「見た目は1文字なのに、なぜかもう入らない」という状況を検証したいとき、本ツールで同じ文字を4通りの数え方で並べて見ると、どの数え方でつまずいているのかを切り分けられます。
エスケープ表記をコードを書く際の参考にする
各カードには、HTML・CSS・JavaScriptのエスケープ表記が並んで表示されます。使用場所に合った構文や引用符も必要です。CSSで後ろに16進数として読める文字を続ける場合は、区切りの空白を入れるなどしてエスケープの範囲を明確にしてください。HTMLは あ のような数値文字参照、CSSは \3042 のようなバックスラッシュ表記、JavaScriptは \u3042 形式で、U+FFFF を超える文字は \u{1F600} のような波括弧付きの表記になります。
エスケープ表記は、環境によって文字そのままでは扱いづらい場面で効いてきます。CSSの content プロパティにアイコン用の記号を入れたいとき、ソースファイルの文字コードに左右されないようエスケープで書いておく。HTMLで表示が化けやすい特殊な記号を数値文字参照にしておく。JavaScriptの文字列で、見た目では区別できない空白の種類を明示的に書いておく。そういった使い方です。とくに最後は重要で、ソースコードの中に全角スペースやゼロ幅文字を「そのままの文字」で書いておくと、次に触る人にはまず気づけません。エスケープで書いてあれば、そこに意図があることが読み取れます。
活用シーン
- 検索やフィルタに引っかからない文字列の原因を突き止めたいとき
- CSVやJSONの読み込みでずれ・エラーが起きる原因を、文字レベルで確かめたいとき
- CSSやプログラムの識別子に、全角スペースや見えない文字が混ざっていないか調べたいとき
- 絵文字が何個のコードポイントで構成されているかを確認したいとき
- 文字数制限を調べる前に、文字列のコードポイント構成を確認したいとき
- HTML・CSS・JavaScriptで使うエスケープ表記を手早く調べたいとき
- 手元の文字が半角なのか全角なのか、どのUnicodeブロックの文字なのかを確かめたいとき
- 異体字セレクタが付いた漢字や、絵文字表示と文字表示の切り替えを確認したいとき
コーディングやデータ整理の場面だけでなく、原稿の校正でも役に立ちます。ライターやクライアントから受け取った原稿に、半角と全角のスペースが混在していないか、見えない文字が入っていないかを、入稿前に一度通して確認する使い方です。
よくある質問
Q. 本当に無料で使えますか?
A. はい。ブラウザ上で動く無料Webツールです。インストールやアカウント登録は不要で、ページを開けばすぐに使えます。回数の制限もありません。
Q. 貼り付けた文字はサーバーに送信されますか?
A. いいえ。すべての処理はお使いのブラウザ内で行われ、当方のサーバーへ送信・保存されることはありません。テキストが端末内にとどまる仕組みです。
Q. 絵文字が何個にも分かれて表示されるのはなぜですか?
A. 多くの絵文字は複数のコードポイントの組み合わせでできています。たとえば家族の絵文字はゼロ幅接合子(U+200D)で複数の絵文字をつないだもので、肌色の指定や、絵文字表示と文字表示を切り替える異体字セレクタも別のコードポイントとして加わります。本ツールはそれらを1つずつ分けて表示します。
Q. 文字の正式名称は表示されますか?
A. 本ツールは分類とUnicodeブロック名を表示します。正式名称のデータは膨大なため、ブロック単位での表示にとどめています。正式名称が必要な場合は、表示されたコードポイントで公式のデータベースを検索してください。
Q. 長い文章を貼っても大丈夫ですか?
A. 貼り付けは可能です。ただしカードの一覧表示は先頭300コードポイントまでで、それを超えると「先頭 300 文字を表示しています(全 N 文字)」と表示されます。サマリーの数値は全文が対象です。特定の箇所を詳しく見たいときは、その部分だけを貼り付けるのが確実です。
Q. 文字が四角や「?」で表示されます。
A. お使いのOS・ブラウザ・フォントが、その文字の字形を持っていない場合に起こります。コードポイントやブロック名、バイト列は正しく表示されているため、字形が出なくても文字の特定はできます。
ご利用にあたって
本ツールおよび本ページは現状有姿(as-is)で提供されるため、ご利用は利用者ご自身の責任においておこなってください。本ツールの利用、または利用できなかったことにより生じたいかなる損害についても、AMIXは責任を負いかねます。表示される字形は、お使いのOS・ブラウザ・フォントによって異なる、または正しく表示されない場合があります。分類・ブロック名はコードポイントの範囲に基づく表示であり、Unicodeの版によって細かな扱いが異なる場合があるため、厳密な仕様確認が必要な場面では公式のデータベースを併せてご確認ください。処理はブラウザ内で行われますが、ブラウザの種類・バージョンや端末環境によっては、表示・動作が異なる場合があります。書記素の数え方はブラウザの機能を利用しているため、Intl.Segmenterに対応していない環境ではコードポイント数を代わりに表示します。本ツールの仕様・内容は、予告なく変更または提供を終了する場合があります。
見えないものを見えるようにすれば、原因の切り分けはずっと速くなります。文字まわりで行き詰まったときの一手として、ぜひお試しください。